
《Hands-On Large Language Models》阅读笔记
书籍:《Hands-On Large Language Models》(Jay Alammar、Maarten Grootendorst 著)
1.1 什么是语言人工智能
人工智能 (AI)
人工智能(AI):制造智能机器、特别是智能计算机程序的科学与工程。不必局限于生物学上可观察到的方法。
——John McCarthy,2007
书中指出,AI 这个术语在发展中已被泛化——电脑游戏中的 NPC 常被称为 AI,尽管很多只是 if-else 语句。
语言人工智能 (Language AI)
语言人工智能:AI 的子领域,专注于开发能理解、处理和生成人类语言的技术。随着机器学习方法在语言处理问题上的持续成功,该术语与 自然语言处理(NLP) 经常互换使用。
Tips:
书中的"语言人工智能"覆盖范围比 LLM 更宽,还包括检索系统等非 LLM 技术。作者在第 8 章中将检索系统描述为"赋予 LLM 超能力"的存在。
1.2 语言人工智能的近期发展史
作者抛出一个贯穿全文的核心问题:对计算机来说,文本是非结构化的,当用 0 和 1 表示时便失去含义。 语言人工智能的发展历史,本质上就是不断寻找更好的方式 将语言结构化地表示为计算机能使用的形式。
1.2.1 将语言表示为词袋模型
分词 (Tokenization) / 词元 (Token)
分词:将句子拆分为单个词或子词的过程。拆分后的最小单位称为 词元(Token)。
最常见的做法是按空格分割,但这在汉语等无空格语言中存在天然短板(第 2 章会深入)。
词表 (Vocabulary)
词表:从所有输入句子中提取的、不重复的词元集合。
"My cat is cute"
"That is a cute dog"

       ↓ 按空格分词

My, cat, is, cute
That, is, a, cute, dog

       ↓ 去重合并

词表: [a, cat, cute, dog, is, My, That]
词袋模型 (Bag-of-Words)
词袋模型(BoW):通过统计词表中每个词在句子中出现的次数,将文本转化为数值向量。输出结果为 文档级 Embedding——一个向量代表整篇文档。
"My cat is cute"
  ↓ 查词表计数
  [0, 1, 1, 0, 1, 1, 0]  ← 每个位置对应词表中词的频次
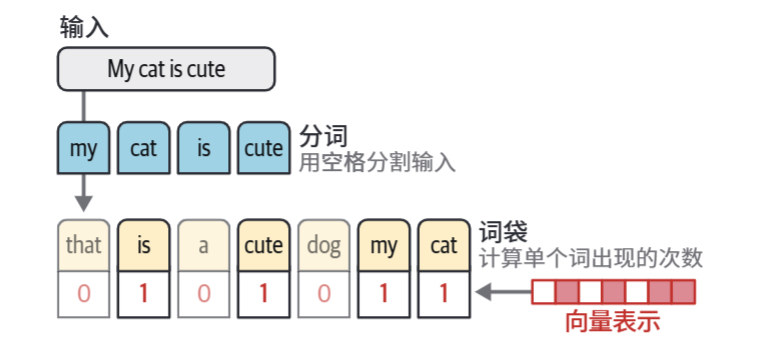
作者在此将这类生成文本向量表示的模型定义为 表示模型(Representation Model)。
Tips:
词袋并未过时——第 5 章会将它与最新语言模型结合使用。
1.2.2 用稠密向量嵌入获得更好的表示
词袋的缺陷
词袋只是字面上的"词袋"——完全无视词的顺序和语义,两个语义完全不同的句子可能产生非常相似的向量。
嵌入 (Embedding)
嵌入(Embedding):数据的向量表示,试图捕捉数据的含义,而非仅仅是字面统计信息。
补充理解:
Embedding 就像给每个词分配一个多维坐标系中的坐标点。含义越相似的词,坐标点越靠近。
Word2Vec
Word2Vec(2013):推动词 Embedding 大规模普及的重要技术之一,通过训练学习能够反映语义关系的稠密词向量。
(这里的核心是word2vec让词可以被表示为稠密数学向量,并使语义相似度、向量关系等操作变得实用)
神经网络
神经网络(Neural Network):由多层互连节点组成的计算结构。每个连接带有权重(即 模型参数),决定信号在上层节点中的传递强度和方向。
词嵌入如何表示含义
- 一个简单词嵌入表示: 苹果(apple) :(2,-1.2,3.2,-5.1,......)。
- 这里每一个值都代表在一个维度上的位置,他们共同组合并一起在一个多维坐标系中代表了一个坐标点。
嵌入的每个维度可以理解为词的某种抽象"属性"。例如 baby 在"newborn"、"human" 维度上得分高,apple 在这些维度上得分低。
实际上,这些所谓属性,是后天由人工总结得出。真实训练过程中,我们并不知道这些属性究竟是什么,因为它是计算机自行总结得出的一种抽象特征。
Word2Vec 的训练过程
作者按步骤展开说明:
为词表中每个词分配一个随机初始化向量嵌入(如每词 50 个随机值)
(此处的50个值,就代表该词嵌入的维度大小为50,你可以简单理解为该词要用50个属性来衡量)
    ↓
每个训练步骤从文本中取出一对词
    ↓
让模型预测:这两个词是否可能出现在彼此的上下文窗口中?
    ↓
模型给出预测(如 0.74 概率)
    ↓
与真实标注对比,反向更新词嵌入
(此处的更新词嵌入,就相当于将该词的维度进行调整,比如某个维度经过训练后,其位置就可能会发生变化)
(正是不断进行该过程,这个50个值才能真正衡量出一个词的语义)
    ↓
重复海量步骤
- 核心逻辑:如果两个词各自的相邻词集合有更大的交集,它们的上下文分布更加相似。
反之亦然。注意上述是相对简化的训练过程。
- Word2Vec 是静态 Embedding——训练完成后每个词的向量固定不变,无法根据上下文动态调整。
- 因为word2vec的产物是静态固定的。
- 比如bank单词,其有银行和河岸的意思。但是在word2vec训练中,他并不能具体区分或者根据句子前后意思,来判断此处的bank是河岸,而不是银行。所以在word2vec训练中,这个bank单词会被在不同句子中均出现的不同释义的词影响,导致其被强行糅合、平均成一个折中的向量。
- 因为word2vec的产物是静态固定的。
语义相似度
通过向量距离度量(如余弦相似度),可以判断两个词的语义接近程度。含义相似的词在高维空间中彼此靠近。
Word2Vec的核心价值和意义
- 将词压缩成几百维的稠密向量,使数学工具(如余弦相似度、欧氏距离等)可以直接作用于文本
- 不再局限于显式词频统计,而是通过上下文共现关系学习稠密表示,使部分语义关系能够体现在向量空间中,真正地捕捉到逻辑关系和语义维度
- 奠定了NLP领域基础思想范式,降低了NLP的入门门槛
这里可以将 word2vec 去 对比 词袋模型和One-hot独热编码,会更好地理解。
1.2.3 嵌入的类型
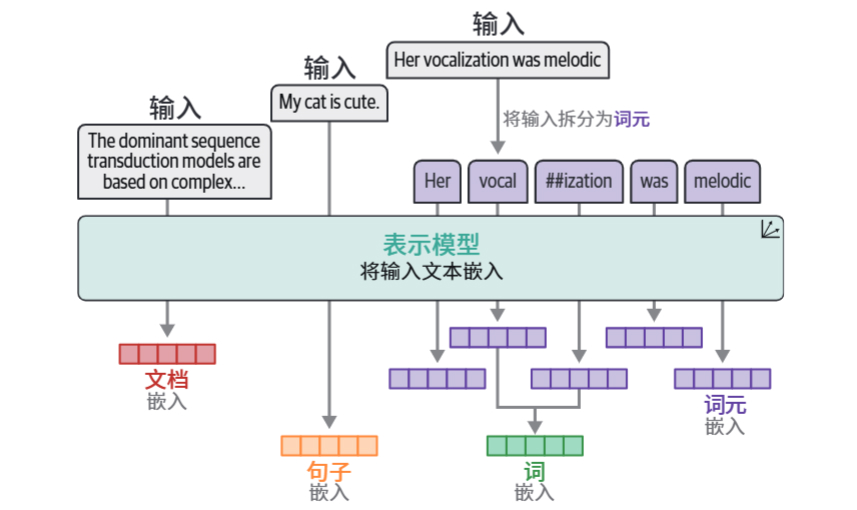
不同粒度的 Embedding:
| 类型 | 粒度 | 代表技术 |
|---|---|---|
| 词元嵌入 | 单个 Token | Word2Vec |
| 句子嵌入 | 整个句子 | BERT ([CLS]) |
| 文档嵌入 | 整篇文档 | 词袋模型 |
Tips:
词袋创建的是文档级 Embedding,Word2Vec 创建的是词级 Embedding。Embedding 在本书后续章节扮演核心角色——分类(第 4 章)、聚类(第 5 章)、语义搜索与 RAG(第 8 章)。
我们接下来都会先讨论词嵌入,其他后续章节会详细讲述
1.2.4 使用注意力机制编解码上下文
Word2Vec 的致命局限:静态 Embedding
Word2Vec 训练完成后,每个词的嵌入是固定的。bank 无论在"河岸"还是"银行"的上下文中,向量完全相同。它无法根据上下文区分一词多义。
RNN (循环神经网络)
RNN(Recurrent Neural Network):在传统神经网络基础上加入了"隐藏状态"机制——上一时间步的隐藏状态参与当前时间步的计算,使得模型能捕捉序列的前后关系。
(简单理解,RNN 在读取当前词时,会携带前面的词逐步累积形成的隐藏状态,因此当前计算能够参考之前的信息)
RNN 被用于两个角色:
- 编码器(Encoder):将输入句子逐词处理,生成上下文向量
- 解码器(Decoder):基于上下文向量,逐词生成输出
RNN 编码器-解码器的工作流程
"I love llamas"  ← 输入序列
       ↓
word2vec 词嵌入
       ↓
编码器 (RNN)  逐词串行处理(1→2→3→4),并更新隐藏状态。
       ↓
上下文向量(用于概括输入序列/隐藏状态)
       ↓
解码器 (RNN)  逐词自回归生成 (自回归指的是输出的词也会作为输入一并传入)
       ↓
"Ik hou van lama's"  ← 输出序列
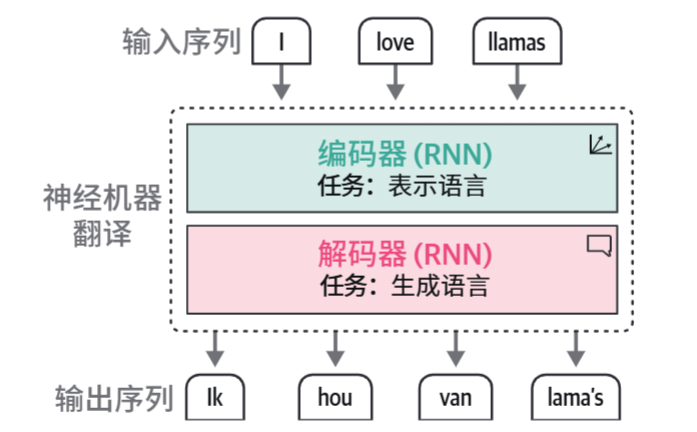
自回归
输出的词也会作为输入一并传入。注意这里包括后续的Transformer都是解码器是自回归的,并不是整体或者编码器也是自回归!
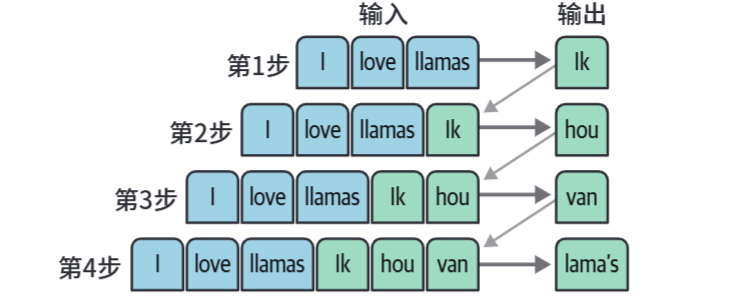
上下文向量的瓶颈
一整个输入最终需要被压缩成一个固定维度的向量。 当输入越来越长时,模型需要把越来越多的信息浓缩到这个有限的表示中,因此重要信息可能逐渐被弱化或丢失,最终导致长文本处理能力下降。
- 我们前面提到了 RNN 的“隐藏状态”,可以把它暂时理解为模型在逐步读取文本过程中不断更新的一份语义记忆。
- 隐藏状态的维度在模型设计时就是固定的,例如设定为 256 维,那么无论输入是 3 个词、30 个词还是 300 个词,编码器始终都需要使用这个固定维度的隐藏状态去表示已经读取到的信息。
- 不同于词嵌入主要表示某一个词,RNN 中的隐藏状态表示的是截至当前时刻已经读取内容的整体状态,因此可以把它理解为一种部分语义快照。
- 随着编码器不断读入新的词,这个隐藏状态也会不断更新,使其逐渐包含更多上下文信息。
- 当整个输入序列读取完成后,最后得到的隐藏状态就可以作为整个输入的上下文表示(Context Representation),交给解码器使用。
这里同样可以借用“高维空间中的语义特征”来辅助理解。我们前面在理解词嵌入向量时也使用了类似的方法进行辅助。
RNN 的隐藏状态也是类似的。你可以为了方便理解,可以辅助认为RNN的隐藏状态的每一个维度相当于一个语义特征,如“天气好坏”、“谁爱谁”、“发生了什么”等等。但是要明确的是,这些只是方便理解进行类比的,RNN 的隐藏状态实际上是通过许多维度共同编码当前句子的各种语义关系。
在上述 RNN Encoder-Decoder 流程中:

输入:
"I love llamas"

编码器首先读取:

"I"
↓
更新隐藏状态
此时隐藏状态可以理解为:
对目前已经读取内容 "I" 的部分语义快照

继续读取:

"love"
↓
再次更新隐藏状态
此时隐藏状态开始综合表示:
"I love"

继续读取:

"llamas"
↓
再次更新隐藏状态

最终得到的隐藏状态,
就是对整个输入:

"I love llamas"

的上下文表示。

随后,解码器根据这个上下文表示,
逐步生成目标语言中的输出。
问题在于:隐藏状态的维度是固定的,而输入长度却可以不断增加。
假设隐藏状态始终是 256 维:
3 个词
↓
压缩到 256 维状态

30 个词
↓
仍然压缩到 256 维状态

300 个词
↓
依然压缩到 256 维状态
输入越长,模型就需要让同一个固定长度的向量同时概括越多的信息。
但这并不意味着:
256 维
=
最多只能保存 256 条语义
也不存在:
第 256 条信息还能保存
第 257 条信息就突然装不下
维度数量和“能保存多少条信息”之间不存在这种一一对应关系。不要被前面对维度的类比辅助理解影响!
更准确的理解是:
固定长度的隐藏状态必须不断浓缩越来越长的输入。随着需要表达的信息越来越多,模型越来越难在这个固定表示中同时保留所有细节和长期依赖关系。
因此,在较长序列中,早期的重要信息可能逐渐被后续信息影响、弱化,模型也更容易丢失远距离的语义关系。
例如:
小明昨天去北京参加会议,
……
中间出现大量内容
……
最后询问:谁去了北京?
如果序列很长,传统 RNN 需要让“小明去了北京”这条早期信息经过许多次隐藏状态更新才能一直保留下来。
随着更新次数增加,这类较早的信息可能逐渐变弱,导致模型最终难以准确利用它。
这就是传统 RNN Encoder-Decoder 的一个重要瓶颈:
需要依靠固定长度的隐藏状态承载整个输入的信息,并且早期信息需要经过连续的状态传递才能影响很后面的输出。
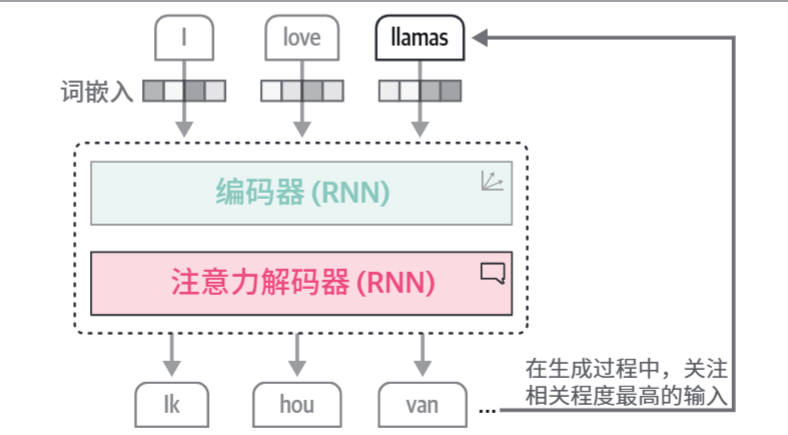
也正因为如此,后来的 Attention(注意力机制) 不再要求解码器只能依赖最后一个固定的上下文向量,而是允许它在生成每一步时,重新查看并选择编码器各个时间步产生的信息。
注意力 (Attention)
注意力(Attention),2014:允许模型根据当前任务动态选择并加权利用不同位置的信息。这里 RNN Encoder-Decoder 中引入的 Attention,是让 Decoder 在每一步生成时关注 Encoder 各时间步的隐藏状态。
也就是不依赖单一上下文向量,而是在解码的每一步,让模型"关注"编码器中所有输入词的隐藏状态,根据与当前生成步骤的相关性分配不同权重。
"Ik hou van lama's"
       ↑↑↑↑
  在生成 "lama's" 时,注意力机制分配最高权重给输入词 "llamas",因为二者含义相同(美洲驼)
补充理解:
从后来 Transformer 的术语来看,这种 Encoder → Decoder 的注意力被称为交叉注意力(Cross-Attention)——解码器在生成时"偷看"编码器输出的输入序列,从而实现源语言到目标语言的精准对齐。与自注意力不同(自注意力是序列内部自己看自己)。
RNN + Attention 的遗留问题
RNN 的串行本质未变——每个时间步依赖上一时间步的输出,无法并行训练。当序列变长,训练时间线性增长。
1.2.5 "Attention Is All You Need"
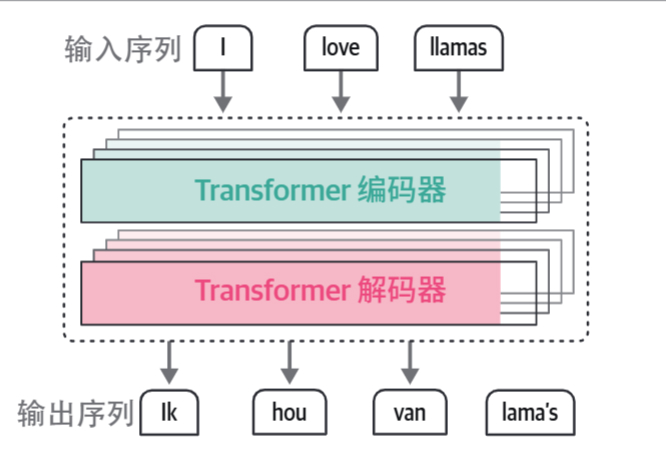
Transformer(2017):彻底抛弃 RNN,架构完全基于注意力机制,解码器同样是自回归。
核心优势:支持并行训练,大幅加快训练速度。
编码器块与自注意力
每个编码器块包含两部分:
输入序列
    ↓
自注意力 (Self-Attention)
    ↓
前馈神经网络 (Feed-Forward Network)
    ↓
输出
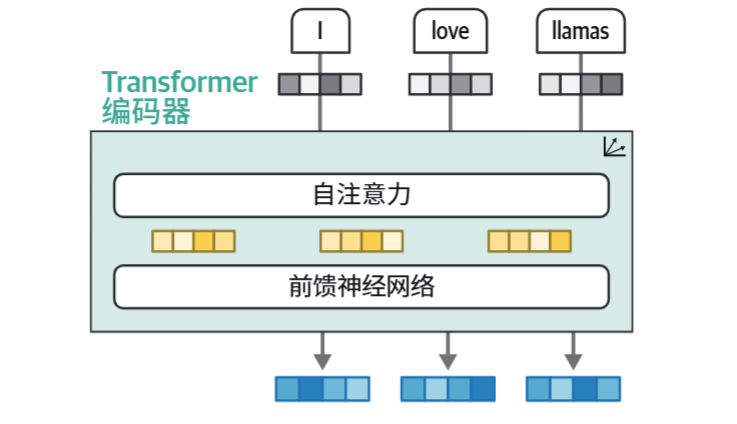
自注意力(Self-Attention):让输入序列内部的每个词元同时"关注"序列中的所有其他词元,一次性计算,不受距离限制。不需要像 RNN 那样串行传递。
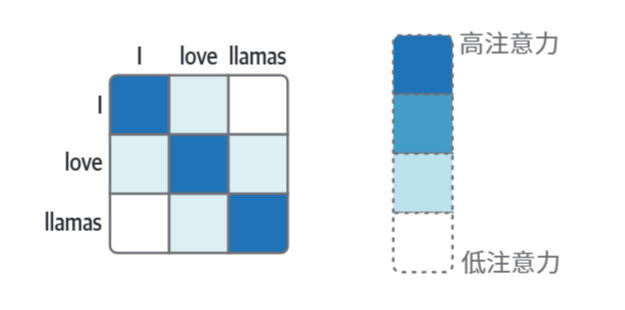
补充理解:
RNN 像“传话游戏”——当前节点直接拿到的是上一时间步传来的隐藏状态,更早的信息需要经过多次传递才能到达当前位置,因此长距离信息更难保留。自注意力是"所有人同时看黑板"——每个词元都能直接看到其他所有词元,不管中间隔了多少个位置。
解码器块与掩码自注意力
解码器块多了一层:掩码自注意力 + 编码器注意力 + 前馈神经网络。
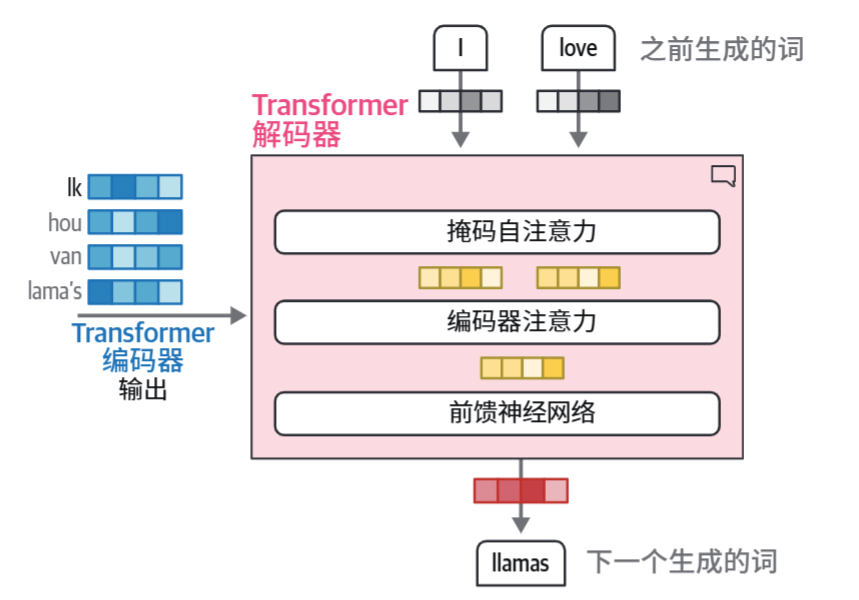
掩码(Mask):掩码自注意力通过屏蔽当前位置之后的 Token,使模型在训练和生成时都只能利用当前位置之前的信息,从而保持自回归特性。
"Ik hou van lama's"

生成 "hou" 时,只能关注 "Ik"(已生成),
不能看到 "van" 和 "lama's"(还未生成)。

这保证了模型的自回归特性——每次都基于历史预测未来。
这里核心在于,我们提供了训练内容:
"Ik hou van lama's"
在训练过程中,模型可能会偷懒直接使用该文本(因为训练时,这些token已经在模型中了)
因为自注意力机制的影响,实际上 这些token之间时可以直接互相看到对方
理想情况:在模型仅知道 IK 的情况下推理出hou。
现实情况:因为有自注意力,所以模型直接输出了hou

这就是一种假的训练,实际上根本没有训练
在生成hou时,保证其只能知道IK。在生成van,只能知道IK hou。这种有限制的自注意力机制就是掩码自注意力
作者提到本章只是 Transformer 的入口介绍。第 2、3 章将深入 多头注意力、位置嵌入 和 层归一化 等让 Transformer 真正成功的机制。
1.2.6 表示模型:仅编码器模型
原始 Transformer 的局限
完整的编码器-解码器结构天然适配翻译任务,但对文本分类等任务并不顺手。
BERT (2018)
BERT(Bidirectional Encoder Representations from Transformers,基于 Transformer 的双向编码器表示):仅使用 Transformer 的编码器部分,完全去除解码器。基座版本包含 12 层编码器堆叠。
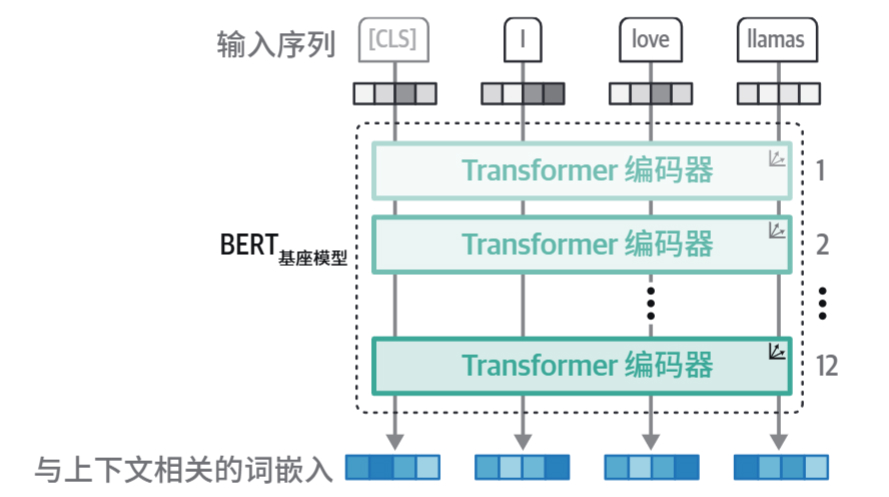
补充理解:
BERT 的 "双向" 本质来自编码器的自注意力机制——可以同时关注上文和下文,而不是 GPT 那种只能看左侧的"单向"。这是理解型模型与生成型模型在注意力上的根本差异。
[CLS] 词元
[CLS] 词元:BERT 在输入序列句首插入的一个特殊词元。经过 12 层编码器处理后,这个词元的输出嵌入被当作整句话的浓缩表示向量,专门用于下游分类等任务。
- 简单理解就是在一个输入序列的首位添加一个CLS词元,用于代表该序列的整句话的语义。
- 可以用于分类等任务;经过合适的训练或 Pooling 后,也可以形成用于相似度和语义检索的文本表示
- 这种“将一段文本压缩为向量表示,再进行相似度比较”的思想,也是后续语义检索和 RAG 检索的重要基础。
- 可以用于分类等任务;经过合适的训练或 Pooling 后,也可以形成用于相似度和语义检索的文本表示
Tips:
[CLS]本身是人为添加的无意义符号,但经过编码器的层层变换后,它从上下文吸收了大量语义信息。GPT 中不存在此设计,因为 GPT 不需要一个"代表整句"的向量——它的任务不是分类,而是逐个生成词元。
掩码语言建模 (MLM)
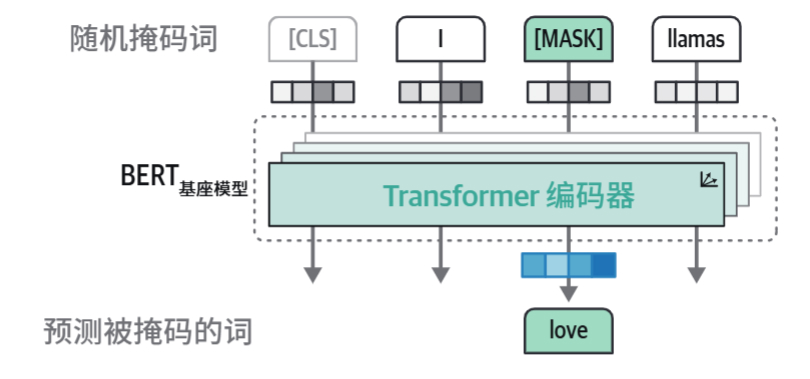
掩码语言建模(MLM):BERT 的预训练方法。随机掩码输入中的部分词元,让模型预测被掩码的原词。
输入:"I [MASK] llamas"
       ↓  12层编码器
       ↓
预测:[MASK] 处应为 "love"
这种"完形填空"式训练让 BERT 学会深度理解上下文关系。
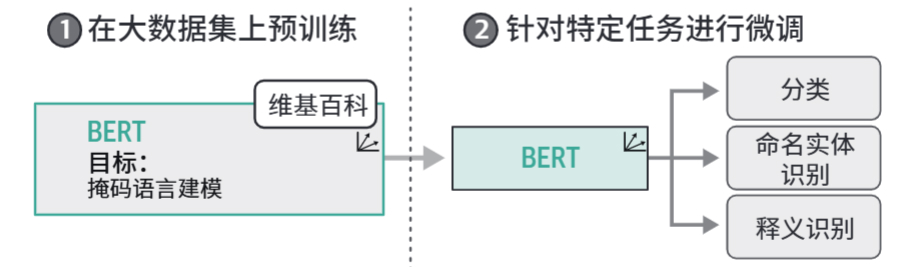
迁移学习:预训练 + 微调
Step 1: 预训练 (Pre-training)
  BERT 在 Wikipedia 等海量文本上做 掩码语言建模(MLM) 训练
  → 获得通用语言理解能力

Step 2: 微调 (Fine-tuning)
  在预训练模型基础上,用少量特定任务数据继续训练
  → 换掉输出头(分类头),适配命名实体识别、情感分类等
Tips:
预训练耗时耗钱(通常只有大厂做),微调成本低且需要的数据更少。
BERT 也可作为"通用特征提取器"——冻结参数不训练,直接取出 Embedding 用于语义搜索等任务
- BERT的多层编码器,每层都关注于不同的方向(注意这里也是一种后天研究总结得出,并非绝对,此处仅为辅助理解)
- 底层(1~4层):更关注词性和语法。
- 中层(5~8层):更关注语义和短句。
- 顶层(9~12层):更关注上下文和全局。
Tips:这是部分 probing / 分析研究观察到的总体趋势,不是 BERT 对各层功能的硬编码划分。不同任务、模型和分析方法得到的结果可能不同。
- 基于上述,在不同层次提取出对应产出的嵌入向量,就可以作为通用特征或者通用语义指纹
-
比如底层关注词性和语法,我们可以提取底层的嵌入变量,用来对词进行词性标注,比如“我(代词) 爱(动词) 吃(动词) 苹果(名词)。
-
比如中层是语义和短句,可以用来从一段文字里抽取出“人名”、“地名”、“机构名”。
-
比如顶层全局
-
BERT
↓
能够产生上下文化表示
↓
经过合适的训练 / Pooling
↓
可以形成句子 / 文档 Embedding
↓
用于语义相似度和检索
-
-
全书术语约定
作者在此约定了一个贯穿全书的命名体系:
| 架构类型 | 书中称呼 | 视觉标识 |
|---|---|---|
| 仅编码器 (BERT 等) | 表示模型 | 蓝绿色 + 向量图标 |
| 仅解码器 (GPT 等) | 生成模型 | 粉红色 + 对话图标 |
1.2.7 生成模型:仅解码器模型
GPT-1 (2018)
GPT(Generative Pre-trained Transformer,生成式预训练 Transformer):仅使用 Transformer 的解码器部分,去掉编码器注意力层。与 BERT 一样堆叠 12 层。
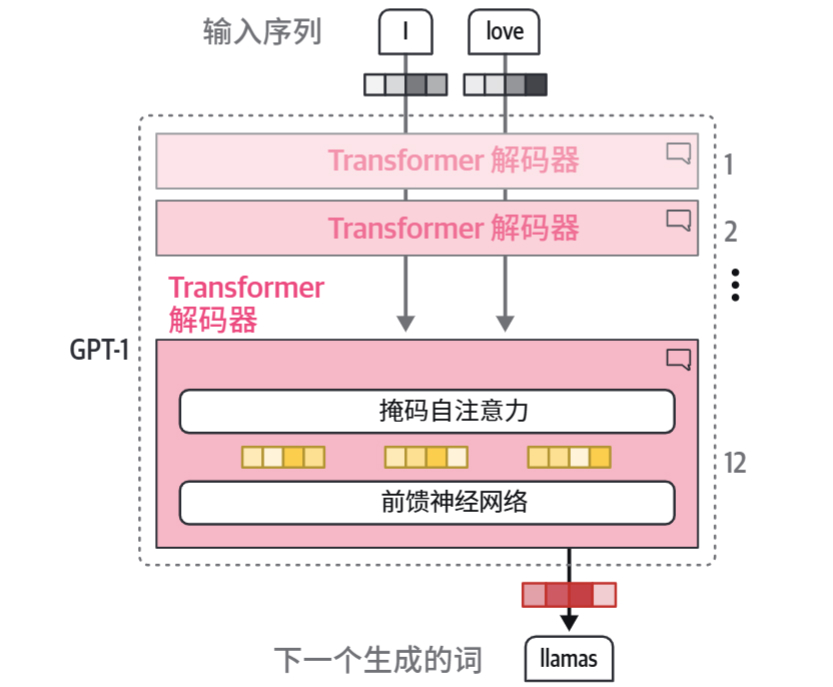
GPT-1 主要在 BooksCorpus 上进行预训练,该数据集包含约 7000 本书籍,总参数量约** 1.17 亿**。
参数规模增长
| 版本 | 参数量 | 年份 |
|---|---|---|
| GPT-1 | 1.17 亿 | 2018 |
| GPT-2 | 15 亿 | 2019 |
| GPT-3 | 1750 亿 | 2020 |
作者在此给出 LLM 的定义:"更大"的生成式仅解码器模型通常被称为大语言模型(LLM),但该术语也涵盖 BERT 等大参数表示模型。
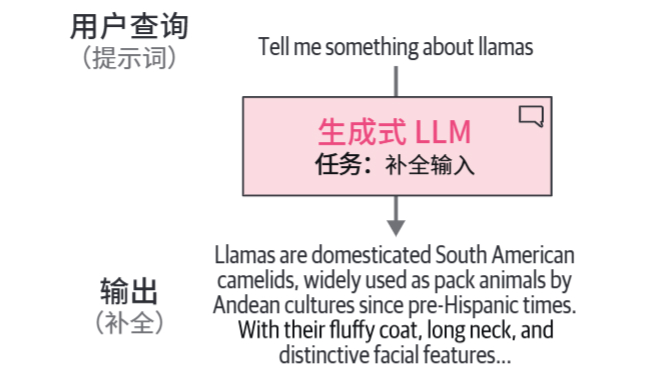
GPT 的生成本质:自动补全
用户输入 (Prompt): "Tell me something about llamas"
       ↓
模型逐词元生成 (自回归):
  "Llamas" → "are" → "domesticated" → "South" → "American" → ...
       ↓
每次生成的新词元追加到输入,形成新的上下文
       ↓
持续生成直到遇到结束标志
指令模型 / 对话模型
原始 GPT 只是一个强大的"补全器"。让它从"补全"升级到"回答问题",靠的是后续的 指令微调(Instruction Tuning)——用大量"用户指令-期望回答"数据对训练模型,使其学会按指令要求生成,而非单纯续写。
补充理解:
这是现代对话模型能够遵循用户指令的重要基础之一。基座 GPT 只会续写——你输入"讲一个笑话",它可能续写为"讲一个笑话是我的爱好";指令微调后,它理解"讲一个笑话"是命令,应该输出一个完整的笑话。
上下文长度 (Context Window)
上下文长度(Context Window):模型一次计算中能够纳入上下文的最大 Token 范围。
简单理解,可以把 Context Window 看作模型当前的工作区大小:
Context Window = 8K

意味着模型一次最多只能在大约 8K Token 的上下文范围内进行计算。
但是需要注意:
Token 位于 Context Window 以内,只代表它进入了模型当前能够处理的范围,并不代表窗口内所有 Token 都一定可以互相关注。
具体“谁能够看到谁”,还取决于模型所使用的注意力机制。
Encoder-only(仅编码器模型/表示模型):双向注意力
以 BERT 这类 Encoder-only 模型为例,Encoder 使用双向 Self-Attention。
假设窗口中存在:
A B C D
在没有其他特殊 Mask 限制的情况下,每个 Token 都可以关注窗口中的其他 Token:
A ↔ B ↔ C ↔ D
例如:
"The bank is near the river"
模型在理解 bank 时,不仅可以利用前面的 The,也可以利用后面的 near the river。
因此 Encoder-only 模型通常可以同时利用一个 Token 左侧和右侧的上下文信息。
可以简单理解为:
Context Window
┌──────────────────────────┐
│ A   B   C   D   E        │
│ ↕   ↕   ↕   ↕   ↕        │
│ 窗口内可以双向建立注意力关系 │
└──────────────────────────┘
Decoder-only(仅解码器模型/生成模型):因果注意力
以 GPT 这类 Decoder-only 模型为例,它通常采用自回归方式:
根据已经存在的 Token,预测下一个 Token。
因此它不能让当前位置看到未来 Token,否则在训练时就相当于提前看到了答案。
所以 Decoder-only 模型通常使用 Causal Mask(因果掩码),形成Causal Self-Attention(因果/掩码自注意力)。
例如窗口中存在:
A B C D
其注意力关系更接近:
A:只能看 A

B:可以看 A、B

C:可以看 A、B、C

D:可以看 A、B、C、D
即:
A   B   C   D

A       ✓   ×   ×   ×
B       ✓   ✓   ×   ×
C       ✓   ✓   ✓   ×
D       ✓   ✓   ✓   ✓
因此对于 Decoder-only 模型:
Context Window 决定哪些 Token 能进入当前上下文范围;Causal Mask 决定进入范围以后,每个位置能够关注哪些 Token。
也就是说:
Context Window
↓
决定“能放进来多少 Token”

Attention / Mask
↓
决定“这些 Token 之间谁能看谁”
所以不能简单地把 Context Window 理解成:
窗口内所有 Token 都能互相注意
更准确的理解应该是:
Context Window 规定模型当前能够纳入计算的最大 Token 范围,而具体的注意力关系由模型架构和 Attention Mask 决定。
补充理解:
对于模型本身而言,当前 Context Window 之外的内容不会直接参与这一次推理。
如果一段历史内容已经不在当前上下文中,那么模型无法再直接通过注意力访问它。现代 AI 系统可能通过 RAG、历史摘要、外部记忆等方式重新取回这些信息,但本质上仍然需要先把相关内容重新放入当前 Context,模型才能利用。
对于 GPT 这类自回归生成模型,每生成一个新的 Token,它都会成为后续生成时上下文的一部分,因此随着输出不断增加,占用的 Context 也会持续增长。
简单理解:
输入 Prompt
↓
占用一部分 Context

生成 Token 1
↓
加入 Context

生成 Token 2
↓
再加入 Context

...
因此 Context Window 通常不仅关系到“最多能输入多少内容”,也会限制模型能够继续生成多少内容。
另外,能够放进 Context Window,并不等于模型一定能够同等有效地利用窗口中的所有信息。Context Window 描述的是模型能够纳入计算的范围,而长上下文中的信息检索和利用能力是另一个问题。
这也是后续 RAG、长上下文优化等技术需要解决的问题之一。
1.2.8 生成式 AI 元年
ChatGPT
ChatGPT:一款产品,而非模型。最初由 GPT-3.5 驱动,后升级至 GPT-4 等更强版本。
基础模型 (Foundation Model)
基础模型:在大规模数据上预训练、能够适配多种下游任务的通用模型,可以是开源模型,也可以是专有模型。(如 Llama、Falcon、Mistral),可供使用者针对指令遵循等特定任务进行微调。
开源 / 专有模型版图
书中列举了 2023 年的模型图景(仅部分):
| 类型 | 代表模型 |
|---|---|
| 专有 | ChatGPT、GPT-4、Claude 2、Gemini、PaLM 2、Grok |
| 开源 | Llama 2 (7/13/70B)、Falcon (7/40B)、Mistral 7B、Mixtral 8×7B、Qwen 7B、Yi 34B |
非 Transformer 新架构
- Mamba:试图达到 Transformer 级别性能,同时提供更大的上下文窗口
- RWKV:追求更快的推理速度