
第 2 章 词元和嵌入:从文本到向量
2.1 LLM 的分词
第 1 章已经看到,模型不是一次性生成所有输出,而是一次生成一个词元。词元不仅是模型的输出单位,也是模型查看输入的方式——发送给模型的提示词首先会被分解成词元。
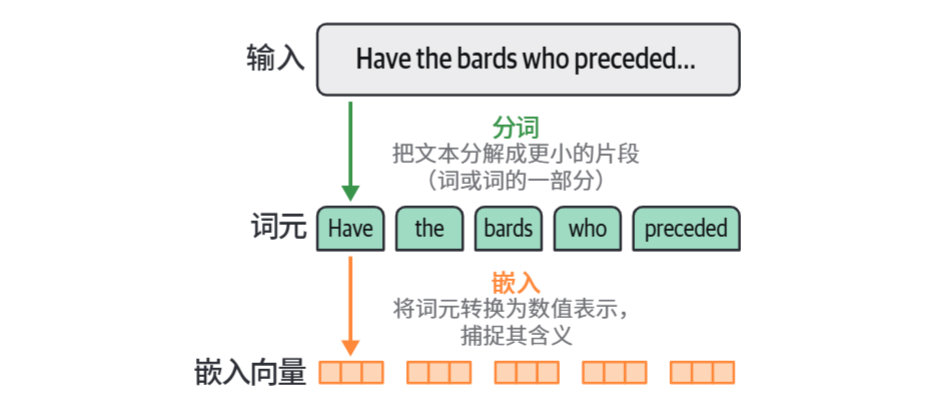
2.1.1 分词器如何处理语言模型的输入
从外部看,生成式 LLM 接收输入提示词并生成响应:
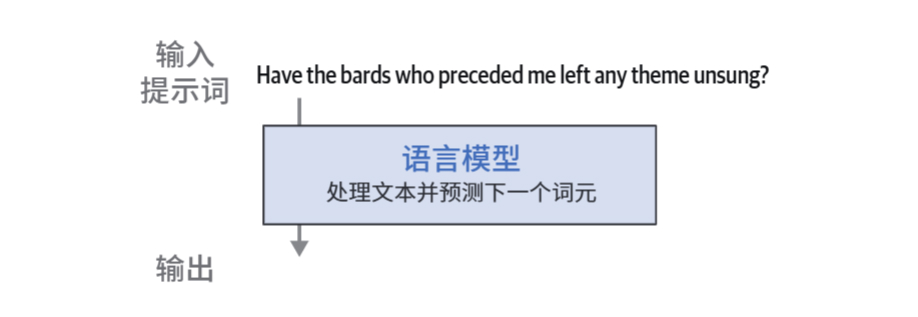
但在提示词呈现给模型之前,它首先要通过分词器被分解成片段:
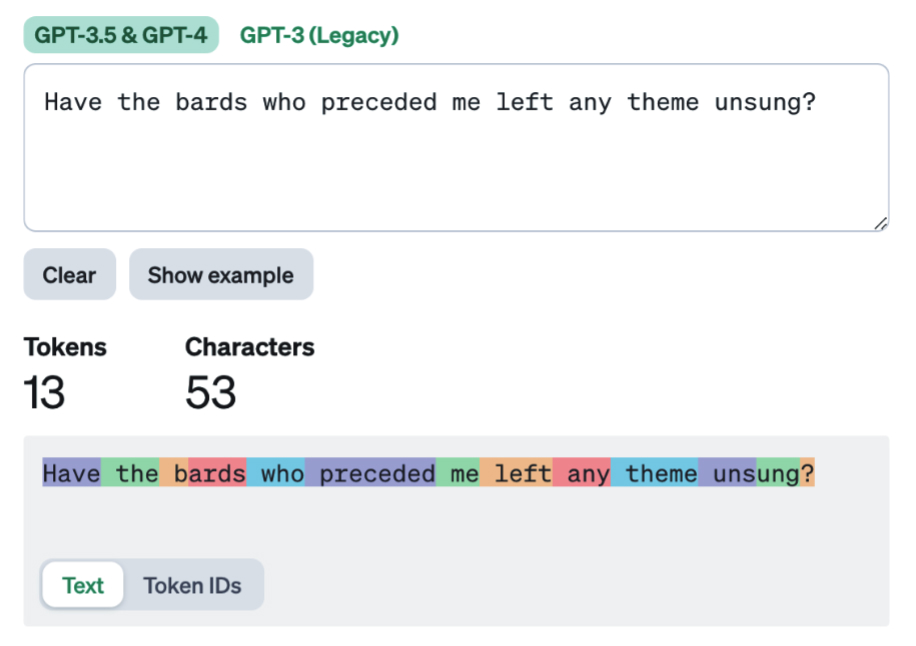
如上图为OpenAI平台展示的 GPT-4o 和 GPT-4o mini 模型的分词器处理示例。
书中用 Phi-3 演示了完整流程——模型实际上并不直接处理提示词文本,输入提示词是由分词器处理的:
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained(
    "microsoft/Phi-3-mini-4k-instruct", device_map="cuda",
    torch_dtype="auto", trust_remote_code=True,
)
tokenizer = AutoTokenizer.from_pretrained("microsoft/Phi-3-mini-4k-instruct")

# 对输入提示词进行分词
input_ids = tokenizer(prompt, return_tensors="pt").input_ids.to("cuda")

# 生成文本
generation_output = model.generate(input_ids=input_ids, max_new_tokens=20)
打印 input_ids,得到的是一串整数:
tensor([[ 1, 14350, 385, 4876, 27746, 5281, 304, 19235, ...]], device='cuda:0')
上面输出的每个整数都是特定词元(字符、词或词的一部分)的唯一 ID,这些 ID 是分词器内部词元表的索引。这才是语言模型的实际输入:
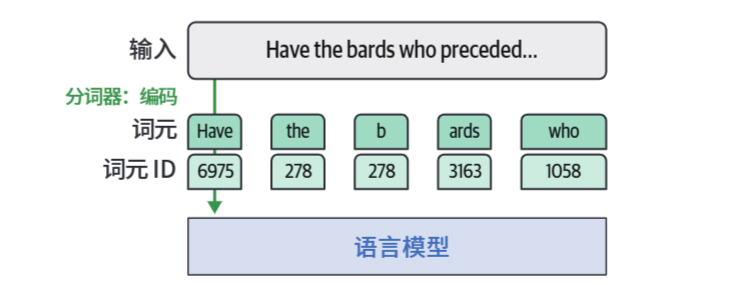
用 tokenizer.decode() 逐个查看这些 ID 对应的词元,可以观察到几个要点:
- 第一个词元(ID 1)是表示文本开始的特殊词元
- 一些词元是完整的单词(
Write、an、email) - 一些词元是单词的部分(
apolog、izing、trag、ic) - 标点符号是独立的词元
- 空格字符不用单独的词元表示——代表词的一部分的词元(如
izing)开头带有一个特殊的隐藏字符,表示与前面的词元相连;没有该字符的词元前面则被视为有一个空格
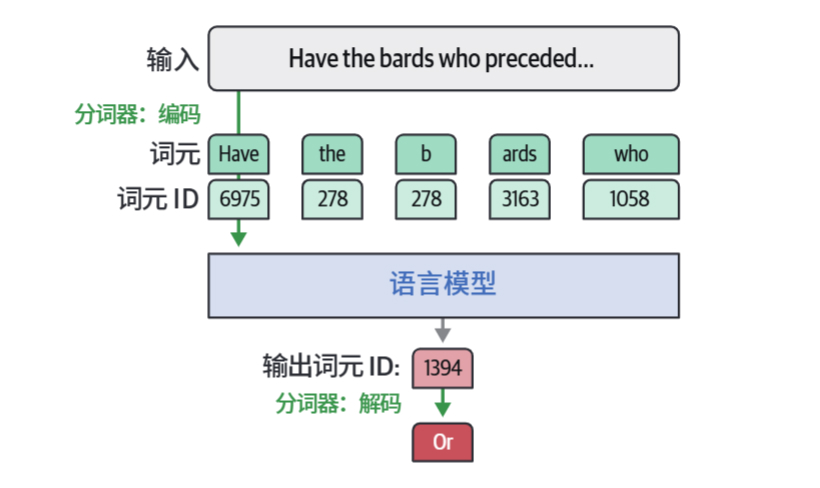
输出端同样依赖分词器:模型生成的是词元 ID,需要分词器解码回文本。例如模型生成词元 3323(Sub)接着 622(ject),合起来才是 Subject:
2.1.2 分词器如何分解文本
决定分词器行为的因素主要有三个:
- 分词方法:模型设计时选定。流行的方法包括字节对编码(BPE,广泛用于 GPT 模型)和 WordPiece(用于 BERT)。它们的共同目标是找到一组尽可能高效的词元来表示文本数据集,但实现方式不同。
- 分词器设计参数:词表大小、使用哪些特殊词元、是否大小写敏感等(2.1.6 节展开)。
- 训练数据集:分词器需要在特定数据集上训练,以建立最能表示该数据集的词表。因此,即使方法与参数完全相同,在英语文本上训练出的分词器,也会与在代码或多语言文本上训练出的分词器表现不同。
2.1.3 词级、子词级、字符级与字节级分词
2.1.1 中 Phi-3 分词器的切分方式——把 apologizing 拆成 apolog + izing,把 mishap 拆成 m + ish + ap,即词元既可以是完整的词、也可以是词的一部分——这种方案被称为子词级分词(subword tokenization)。它是最常用的方案,但并非唯一。
四种主要分词方式:
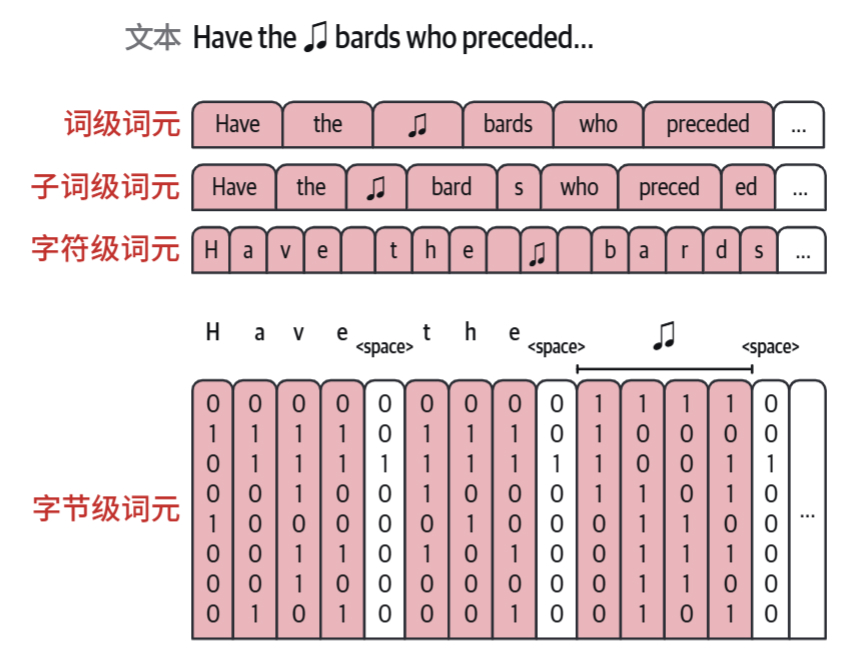
| 方式 | 说明 | 主要问题 / 优势 |
|---|---|---|
| 词级 | 早期 word2vec 等模型常用,如今在 NLP 中使用越来越少 | 无法处理训练后出现的新词;词表中存在大量仅细微差别的词元(apology / apologize / apologetic / apologist) |
| 子词级 | 包含词和词的一部分,主流方案 | 有共享的词根/后缀词元(apolog + -y/-ize/-etic),词表更具表达能力;能将新词分解为已知子词 |
| 字符级 | 只依赖最原始的字母 | 分词容易但建模更难——模型需要额外建模"p-l-a-y 拼出 play"这一层信息 |
| 字节级 | 词元分解为表示 unicode 字符的单个字节,又称"免分词编码" | 在多语言场景颇具竞争力(如 ByT5、CANINE 等工作) |
子词级分词相对字符级的一个实际优势:在有限的上下文长度内能容纳更多文本。上下文长度为 1024 的模型中,子词级分词大约能容纳字符级分词三倍的文本(平均每个词元约三个字符)。
补充理解:
需要区分"子词分词器把字节作为兜底词元"和"字节级免分词器"。GPT-2、RoBERTa 的词表中也包含字节词元,用于表示无法以其他方式表示的字符(Byte Fallback),但它们并非用字节表示所有内容,因此不算免分词的字节级分词器。另外,字节兜底保证了"能表示"(一个 Byte 只有 2^8 = 256 种可能,覆盖 256 种字节值即可表示任意文本),但能表示 ≠ 能理解——如果训练数据中几乎没有某种语言,模型仍然不理解它。
2.1.4 比较训练好的 LLM 分词器
作者用同一段混合文本(大小写、中文、emoji、代码、数字、特殊词元)横向对比了 8 个实际训练好的分词器:
| 模型 | 分词方法 | 词表大小 | 行为特点 |
|---|---|---|---|
| BERT 基座(大小写不敏感,2018) | WordPiece | 30,522 | 换行符消失;全部转小写;capital + ##ization(## 表示与前词元相连);emoji 和中文变成 [UNK] |
| BERT 基座(大小写敏感,2018) | WordPiece | 28,996 | 保留大写,但 CAPITALIZATION 被拆成 8 个词元;均在首尾添加 [CLS] / [SEP] |
| GPT-2(2019) | BPE | 50,257 | 保留换行符和大小写;emoji/中文拆为多个字节词元,可无损重构;特殊词元仅 <|endoftext|> |
| FLAN-T5(2022) | SentencePiece | 32,100 | 无换行/空白字符词元 →处理代码具有挑战性;emoji 和中文被替换为 ``,完全无法识别 |
| GPT-4(2023) | BPE | 略多于 100,000 | 各种长度的空白序列(最多 83 个)各有专属词元;elif 等 Python 关键字有独立词元;用词元更少(CAPITALIZATION 从 4 个降到 2 个);新增 <|fim_prefix|> 等中间填充词元 |
| StarCoder2(2024) | BPE | 49,152 | 代码专用模型:每个数字单独成词元(600 → 6 0 0);用特殊词元表示仓库名和文件名,以区分不同文件/仓库的代码 |
| Galactica | BPE | 50,000 | 科学知识专用:[START_REF]/[END_REF] 包裹引用;有用于思维链推理的特殊词元;唯一把 "\t\t" 分配为单词元的分词器 |
| Phi-3(复用 Llama 2) | BPE | 32,000 | 新增对话角色词元 <|user|>、<|assistant|>、<|system|>,适配对话应用 |
几个关键观察:
- BERT 的特殊词元体系:
[UNK](未知词元)、[SEP](分隔两段文本,第 8 章重排序会用到)、[PAD](填充至固定长度)、[CLS](分类)、[MASK](训练时掩码)。 - 空白字符的意义:能用单个词元表示连续四个空白的模型更适合处理 Python 代码。若拆成四个词元,模型需要额外追踪缩进级别,通常导致性能下降。合理选择分词粒度,可以帮助模型在特定任务上取得更好表现。
- StarCoder2 逐数字分词的设计动机:GPT-2 中 870 是单个词元,871 却是两个词元(
8+71)——这种不一致可能让模型混淆对数字的理解。 - 从 GPT-2 到 GPT-4 再到 StarCoder2/Galactica,可以看到专门领域(代码、科学)的模型通常需要专门设计的分词器。
2.1.5 分词器属性
是什么决定了分词器的分词行为?三大类设计选择:
- 分词方法:BPE 最流行。每种方法定义了一种选择词元集的算法。
- 初始化参数:
- 词表大小:常见 30K、50K,越来越大(如 100K)
- 特殊词元:文本开始/结束、填充、未知、CLS、掩码词元等;还可针对领域添加(如 Galactica 的
[START_REF]) - 大小写处理策略:全转小写会丢失大小写携带的信息,但保留全大写单词又会额外占用词表空间
- 数据领域:即使方法和参数相同,分词器行为也因训练数据集而不同(这甚至发生在模型训练开始之前)。
同样一段 Python 代码:

    def add_numbers(a, b):
    ....return a + b

面向自然语言训练的分词器:
    可能把 4 个缩进空格拆成多个独立词元
    → 模型需要额外追踪缩进层级,建模更费力

在代码语料上训练的分词器(如 StarCoder2):
    把连续空白合并为单个词元
    → 词表本身就是为代码"量身定制"的
这就是 2.1.4 中 StarCoder2、Galactica 等专用模型要单独训练分词器的原因——分词方法的优化目标就是让词表尽可能高效地表示它自己的那份训练数据,数据不同,最优词表自然不同。
补充理解:
词表大小(Vocabulary Size)和上下文窗口(Context Window)是两个独立概念。 可以类比:词表大小 = 乐高积木有多少种,上下文窗口 = 桌子一次能放多少块。另外,遇到词表里没有的新词时,分词器不会临时创建新词元——而是把它拆成更小的已有词元,必要时一直拆到字节级。词表在训练完成后就是固定的。
2.2 词元嵌入
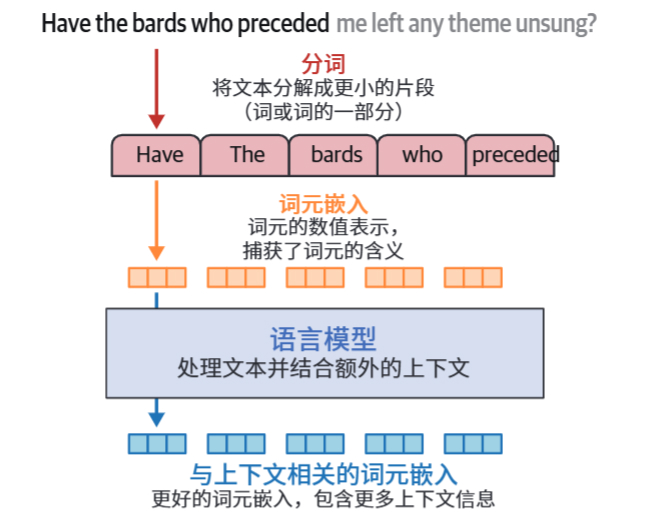
分词解决了"把语言变成词元序列"的问题,下一步是为这些词元找到最佳的数值表示,使模型能够计算并建模文本中的模式——这就是嵌入的作用。
2.2.1 语言模型为其分词器的词表保存嵌入
分词器经过初始化和训练后,会在其关联语言模型的训练过程中使用。预训练语言模型与其分词器是绑定的,未经训练不能使用不同的分词器。
语言模型为分词器词表中的每个词元都保存了一个嵌入向量。下载预训练模型时,模型的一部分就是保存所有这些向量的嵌入矩阵:
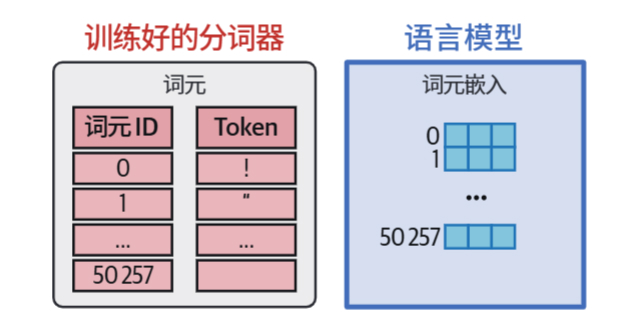
在语言模型训练开始之前,这些向量像模型其他权重一样被随机初始化,训练过程为它们调正修正值,使其具备真正有意义的行为。
简单理解就是,这些词元的真正有意义的向量是在模型预训练中才慢慢形成的,是同模型一起训练的,并非是一种提前单独获取的嵌入向量,再交给模型。
补充理解:
Token ID 本身只是编号/索引。嵌入矩阵的维度是词表大小 × 嵌入维度,所谓"取嵌入"本质上是一次查表(取矩阵的第 N 行),速度极快;真正昂贵的是后面的 Transformer 计算。还要注意区分两个训练过程:Tokenizer 训练学的是"文本怎么切比较合适"(此时词元 ID 只是编号,不需要语义向量);LLM 训练才是通过预训练任务反向传播,把嵌入矩阵和 Transformer 参数一起更新。LLM 的词元嵌入是 LLM 训练的一部分,而不是先用 Word2Vec 单独算好再装进去。
2.2.2 使用语言模型创建与上下文相关的词嵌入
语言模型不仅消费词元嵌入,还能创建更好的词元嵌入——这是用语言模型做文本表示的主要方式之一,支撑了命名实体识别(NER)、抽取式文本摘要等应用。
与静态向量不同,语言模型创建的是与上下文相关(contextualized)的词嵌入:根据词元在上下文中的含义使用不同的表示。这些向量还为 DALL·E、Midjourney、Stable Diffusion 等 AI 图像生成系统提供了支持。
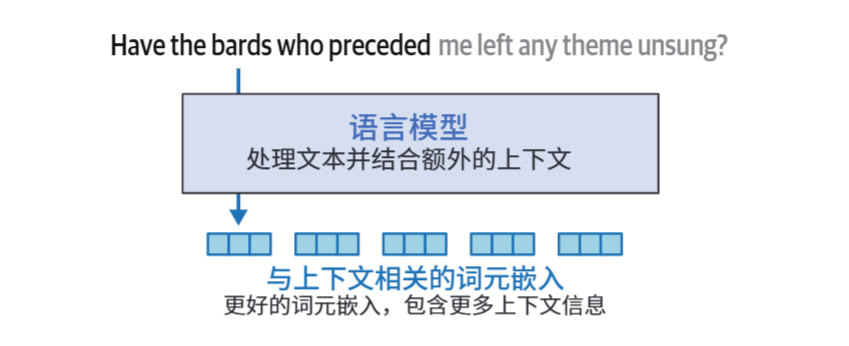
| 步骤 | 嵌入 | 意义 |
|---|---|---|
| 2.2.1 预训练得出的嵌入向量 | 初始词元嵌入(Token Embedding) | 词表中的每个词元都有一个固定的嵌入向量,保存在模型的嵌入矩阵中。这些向量在预训练过程中与模型其他参数一起学习得到,作为词元进入 Transformer 前的初始表示。 |
| 2.2.2 语言模型创建的上下文相关词嵌入 | 上下文化词嵌入(Contextualized Embedding) | 初始词元嵌入经过 Transformer 处理后,会结合当前上下文形成新的表示。因此,同一个词元在不同上下文中可以得到不同的向量表示,从而表达其在当前语境下的含义。 |
一个具体的例子
假设在预训练数据中,“苹果”作为水果的用法远多于作为 Apple 公司/产品的用法,因此其初始词元嵌入可能更受水果相关语义影响。
那么我们在经过预训练后获取到的初始嵌入向量就是:
苹果(数据集) —> 模型预训练后内置了该词元嵌入向量 —> 该嵌入向量含义更偏向于苹果(水果)
而我们在具体让语言模型推理时,我们输入:“我今天买了个苹果,感觉他的电池不耐用。”
这个时候的流程就是:
苹果 —> 获取到初始嵌入 —> 其随着整句话组成的上下文在Transformer处理后 —> 根据上下文得出得新的嵌入向量 —> 含义更偏向于苹果手机
所以最核心的区别可以压缩成:
初始 Token Embedding:这个 Token 本身的固定初始表示。
Contextualized Embedding:这个 Token 在“当前上下文中是什么意思”的动态表示。
书中用 DeBERTaV3(撰写本书时最适合生成词元嵌入的模型之一,体积小、效率高)演示:
from transformers import AutoModel, AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("microsoft/deberta-base")
model = AutoModel.from_pretrained("microsoft/deberta-v3-xsmall")

tokens = tokenizer('Hello world', return_tensors='pt')
output = model(**tokens)[0]
output.shape
# torch.Size([1, 4, 384])
[1, 4, 384] 的含义:
- 第 1 维:批次(batch)维度,用于同时处理多个输入句子
- 4:词元数——
"Hello world"实际被拆成[CLS]、Hello、world、[SEP]共 4 个词元 - 384:每个词元嵌入为 384 维向量
至此可以回顾完整链路——将词元 ID 转换为原始嵌入向量,是语言模型内部发生的第一步:
2.3 文本嵌入(用于句子和整篇文档)
许多 LLM 应用需要处理完整的句子、段落甚至文档,这催生了专门的文本嵌入模型:接收一段文本,最终生成单个向量来表示它并捕捉其含义。
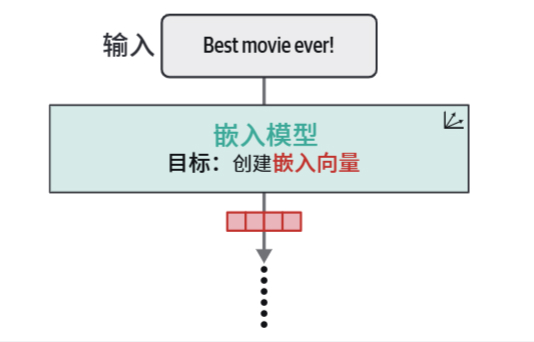
生成文本嵌入最常见的方法之一是对模型输出的所有词元嵌入取平均值,但高质量的文本嵌入模型往往是专门为嵌入任务训练的。
书中用 sentence-transformers 软件包演示(all-mpnet-base-v2 模型):
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/all-mpnet-base-v2")
vector = model.encode("Best movie ever!")
vector.shape
# (768,)
这个句子被编码成一个 768 维向量。嵌入向量的维度取决于底层的嵌入模型。
这些文本嵌入向量将在分类、语义搜索和 RAG 等应用中发挥巨大作用(本书第二部分展开)。
2.4 LLM 之外的词嵌入
嵌入不仅在文本和语言生成上有用——为对象分配有意义的向量表示这件事在推荐引擎、机器人技术等许多领域都很有价值。这里举例 word2vec 是如何创建词嵌入的,它的训练方式为后续第 10 章的对比训练做铺垫。
这里的操作示例如果不想看示例或者看不懂,可以直接看从2.4.3补充理解开始看。
2.4.1 使用预训练词嵌入
用 Gensim 库可以直接下载预训练词嵌入(word2vec、GloVe 等)并探索嵌入空间:
import gensim.downloader as api

model = api.load("glove-wiki-gigaword-50")  # 维基百科训练,50 维
model.most_similar([model['king']], topn=11)
king 的最近邻是 prince、queen、emperor、kingdom、throne 等——嵌入空间中的距离确实反映了语义关系。
2.4.2 word2vec 算法与对比训练
与 LLM 一样,word2vec 也是在从文本生成的样本上训练的。以 Dune 中的句子 "Thou shalt not make a machine in the likeness of a human mind" 为例:
第一步:滑动窗口生成正例。 设窗口大小为 2,考虑中心词两侧各两个相邻词。以 not 为中心词时生成四个训练样本:
词 1    词 2     目标值
not     thou     1
not     shalt    1        ← 正例:确实是相邻词
not     make     1
not     a        1
第二步:随机采样制造负例。 如果数据集里只有目标值为 1 的样本,模型会投机取巧——永远输出 1 就能获得完美表现。因此需要随机取一些词标注为"非相邻":
thou    apothecary   0
not     sublime      0      ← 负例:通常不相邻的词
make    def          0
a       playback     0
选择负例时并不需要过于严谨——仅仅借助"从随机样本中检测正例"的能力就能得到很有用的模型(这受到噪声对比估计的启发)。
至此得到 word2vec 的两个核心思想:
- skip-gram:选择相邻词的方法(滑动窗口取样)
- 负采样(negative sampling):通过随机采样添加负例
第三步:训练。 为词表中每个词元创建一个随机初始化的嵌入向量(实践上是一个 词表大小 × 嵌入维度 的矩阵),然后让神经网络接收两个词的嵌入向量、预测它们是否相邻:
随机初始化嵌入矩阵
    ↓
输入一对词的嵌入向量 → 神经网络预测:相邻?(如 0.90)
    ↓
与目标值对比,反向调整嵌入向量
    ↓
重复海量样本 → 词表中所有词元获得更好的嵌入
2.4.3补充理解:
这种方法为什么能产生"语义"?背后是分布式假设(Distributional Hypothesis):一个词经常出现在什么样的环境中,可以反映它的含义。语料中"猫"和"狗"总出现在类似上下文("养了一只~"、"可爱的~"、"给~喂食"),为了完成预测任务,模型只能把它们学成相似的向量。
也就是说,嵌入的意义不是人工规定的,而是在训练目标和数据共同作用下"学"出来的——这是理解一切 Embedding 的关键抽象。
简单理解就是,在特定任务下进行训练,获取的词嵌入是和该场景是高度相关的,其意义也是又该任务训练中得出的。
比如我们要做一个用于判断评论是“正面”还是“负面”。
训练数据可能是:
“好吃”  → 正面
“美味”  → 正面
“满意”  → 正面
“难吃”  → 负面
“恶心”  → 负面
“失望”  → 负面
最后得出的嵌入向量:
好吃 ≈ 美味 ≈ 满意 → 正向

难吃 ≈ 恶心 ≈ 失望 → 负向
这里得到的嵌入并不是对一个词“完整含义”的描述,而是更突出训练任务所关注的特征。正如上述例子,我们更关注一个词表达的是正面还是负面情感,因此“好吃、美味、满意”可能形成相似的表示,而“难吃、恶心、失望”则形成另一类表示。
作者强调:"接收两个向量并预测它们是否具有某种关系"是机器学习中最强大的思想之一,在语言模型中屡试不爽——第 10 章会专门讨论它如何优化句子嵌入和检索;它也是连接文本和图像等模态的核心(第 9 章多模态:给模型一张图和一段描述,预测文本是否描述了这张图)。
2.5 推荐系统中的嵌入
本节是 word2vec 思想的一个应用案例:把每首歌曲当作一个词元、把每个播放列表当作一个句子,就可以直接套用 word2vec 训练歌曲嵌入,推荐"经常出现在同一个播放列表中"的歌曲。
Word2Vec              推荐系统
词              →     歌曲
句子            →     播放列表
词 ID           →     歌曲 ID
词 Embedding    →     歌曲 Embedding
书中用电台播放列表数据集训练后(Word2Vec (playlists, vector_size=32, window=20, negative=50)),效果验证:Metallica 的"Fade To Black"的最近邻全部是 Van Halen、Dio、Guns N' Roses、Judas Priest 等重金属/硬摇滚歌曲;2Pac 的说唱歌曲的最近邻也都是 Nas、Ice Cube、Snoop Dogg 等说唱作品。
这一节的核心不在代码,而在于确认了一条主线:
Embedding 不限于文本——歌曲、商品、用户、图片都可以被嵌入。设计什么训练任务,向量就可能学到什么关系:
Word2Vec        → 学词语共现关系
歌曲推荐        → 学歌曲共同出现关系
文本检索嵌入    → 学文本语义相似关系
图文模型        → 学图片和文字的对应关系